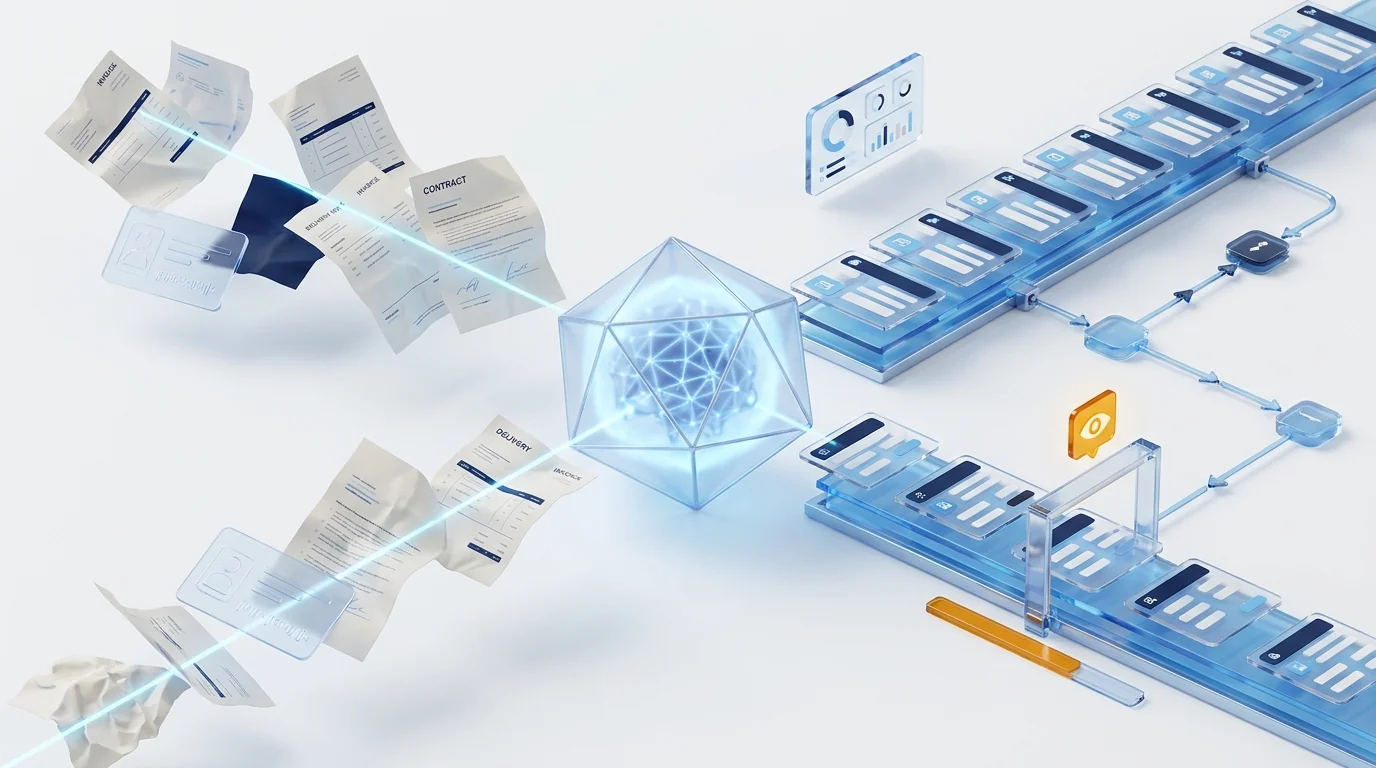
Le traitement intelligent des documents (IDP) combine OCR et intelligence artificielle pour classer les documents, extraire leurs données avec leur signification et les valider avant de les livrer au processus ou à l’ERP. Contrairement à l’OCR classique, il n’a besoin ni de gabarits ni d’entraîner un modèle par type de document : l’IA actuelle localise les champs même si elle n’a jamais vu ce format, et n’envoie en révision humaine que les cas douteux.
Qu’est-ce que l’IDP et en quoi dépasse-t-il l’OCR classique
Le traitement intelligent des documents (IDP, pour Intelligent Document Processing) est une chaîne de quatre étapes que l’OCR classique ne couvrait qu’à moitié : classer le document reçu, extraire les données pertinentes avec leur signification, valider ces données contre des règles métier et livrer le résultat au processus qui en a besoin. La différence pratique se voit mieux en tableau :
| OCR traditionnel | IDP avec IA | |
|---|---|---|
| Ce qu’il renvoie | Du texte brut : l’image convertie en caractères | Des données structurées : fournisseur, montant, échéance, clauses… |
| Formats nouveaux | Chaque fournisseur ou gabarit nouveau exige de configurer des zones à la main | Localise les champs par signification : tolère des formats jamais vus |
| Classification | Manuelle ou par règles fragiles (nom du fichier, code-barres) | Automatique : distingue facture, contrat, bon de livraison ou pièce d’identité par le contenu |
| Erreurs et doutes | Découverts après coup, quand la donnée est déjà fausse dans le système | Confiance par champ + validations : seul le douteux part en révision humaine |
| Mise en œuvre | Projet de gabarits et d’entraînement pour chaque type de document | Configuration : on indique les champs recherchés et on ajuste les seuils |
Si votre organisation cohabite encore avec des dossiers de scans et de la saisie manuelle, le point de départ est le même que celui que nous décrivons dans le guide de l’automatisation des workflows ; l’IDP en est la marche suivante.
Pourquoi 2026 est le point de bascule
Le concept d’IDP existe depuis des années ; ce qui a changé, c’est la technologie sous-jacente et le contexte :
- Modèles de langage avec vision : l’extraction « zero-shot » — demander au modèle les champs que vous cherchez sans lui montrer d’abord des centaines d’exemples — a remplacé les gabarits et les projets d’entraînement par type de document. C’est le même saut que nous décrivons dans LLM et RAG dans Dokuflex, appliqué à la capture.
- Un marché qui s’envole : les analystes de Fortune Business Insights estiment le marché mondial de l’IDP à environ 14,2 milliards de dollars en 2026, avec une projection au-delà de 91 milliards en 2034 — la finance et la comptabilité en tête des domaines d’application.
- La réglementation pousse : en Espagne, VERI*FACTU et la facture électronique B2B obligatoire transforment le circuit des factures en un processus digital de bout en bout. Pendant la transition, factures structurées et documents en PDF ou papier cohabiteront — et quelqu’un (ou quelque chose) devra les capturer.
- L’agenda de l’automatisation : selon Gartner, 40 % des applications d’entreprise intégreront des agents d’IA pour des tâches spécifiques d’ici fin 2026. Les documents sont la matière première d’une bonne partie de ces tâches : sans capture fiable, pas d’agent utile.
En résumé : la barrière technique est tombée juste au moment où la pression réglementaire et concurrentielle montait. Voilà pourquoi l’IDP est passé du projet pilote à la ligne budgétaire.
Où l’appliquer d’abord : les cinq flux au meilleur retour
- Factures fournisseurs : le classique, par volume. Capture de l’en-tête et des lignes, rapprochement avec la commande, et entrée directe dans le circuit d’approbation. C’est aussi l’antichambre de la conformité réglementaire dont nous parlons dans le guide de la facture électronique obligatoire en Espagne.
- Notes de frais et tickets : photo depuis le mobile, extraction du montant, de la TVA et du commerce, et politique de frais appliquée automatiquement — par exemple avec l’application mobile Dokuflex.
- Contrats : identification des parties, dates, montants, échéances et clauses sensibles, avec alertes avant les reconductions tacites.
- Bons de livraison et commandes : rapprochement bon de livraison–commande–facture sans saisie, le triangle où se perdent le plus d’écarts.
- Dossiers et créations de comptes client ou salarié : pièces d’identité, certificats et formulaires classés et vérifiés dès l’entrée, alimentant directement le dossier digital.
La règle pour choisir le premier flux : volume élevé, données répétitives et un processus clair en aval. Un pilote sur l’entrée des factures se mesure en semaines, pas en trimestres.
La donnée ne vaut rien hors du processus
C’est là qu’échouent beaucoup de projets d’IDP « de laboratoire » : ils extraient les données à merveille… vers un fichier Excel. Si l’extraction ne débouche pas sur un processus, vous n’avez fait que déplacer la saisie. Les questions qui définissent la valeur réelle viennent après la capture :
- Qui approuve cette facture et avec quels plafonds par montant ?
- Que se passe-t-il si le montant ne concorde pas avec la commande ou si le numéro fiscal est invalide ?
- Où reste audité qui a corrigé quel champ et quand ?
- Comment la donnée validée arrive-t-elle à l’ERP sans une intégration fragile de plus ?
Toutes ont la même réponse : l’IDP doit vivre dans un BPM. La capture est une étape du flux ; la validation humaine des cas douteux est une autre étape du même flux, avec son responsable et son SLA ; et la livraison à l’ERP est un connecteur standard, pas un développement. C’est le même principe de gouvernance que nous appliquons au BPM avec agents IA : l’IA fait le mécanique, les personnes décident du sensible, et tout reste tracé.
Comment Dokuflex y répond : capture, processus et valeur fiscale sur une seule plateforme
Dans Dokuflex, l’IDP n’est pas un produit à part qu’il faudrait intégrer : c’est une capacité native de la même plateforme BPM low-code :
- Classification et extraction avec IA sur n’importe quel canal d’entrée — e-mail, scanner, mobile, dossier surveillé — sans gabarits par fournisseur, au sein de la gestion documentaire avec IA.
- Validation humaine gouvernée : des seuils de confiance et des règles métier décident de ce qui passe seul et de ce qui se révise ; la correction se fait à l’écran et reste auditée.
- Le processus est déjà là : la donnée extraite tombe directement dans le flux d’approbation, avec SLA, escalades et intégration à votre ERP via connecteurs et API — sans coudre entre eux des produits de capture et de workflow de fournisseurs différents.
- Valeur fiscale incluse : la numérisation certifiée homologuée par l’AEAT (l’administration fiscale espagnole) permet de détruire le papier avec toutes les garanties, dans le même flux de capture.
Et comme l’IA s’exécute sous le parapluie européen de la plateforme, le traitement respecte le RGPD sans que vos documents partent vers des services opaques — le détail se trouve dans notre architecture LLM + RAG sous RGPD.
Comment évaluer une solution d’IDP : 6 critères
- Sans gabarits ni entraînements par document. Exigez un essai avec vos documents réels, y compris les moches : scans de travers, nouveaux fournisseurs, langues mélangées.
- Confiance par champ et circuit d’exceptions. Vous devez pouvoir fixer des seuils, et la révision humaine doit être une étape du flux, pas un e-mail.
- Validations métier intégrées. Concordances, référentiels fournisseurs, numéros fiscaux, doublons — avant que la donnée ne touche l’ERP.
- Processus aval sur la même plateforme. Si la capture et le workflow sont deux produits distincts, vous retombez dans le problème d’intégration que l’IDP promettait d’éliminer.
- Conformité européenne vérifiable. Où sont traitées les données, avec quels modèles, et s’il existe une numérisation certifiée AEAT quand il faudra détruire le papier en Espagne.
- Coût par document transparent et ROI mesurable. Documents par mois, minutes économisées par document et taux d’exceptions : avec trois chiffres, vous avez le business case.
Questions fréquentes
Qu’est-ce que le traitement intelligent des documents (IDP) ? +
C’est l’évolution de l’OCR : au lieu de se limiter à transcrire le texte d’un document, l’IDP combine reconnaissance optique et modèles d’IA pour classer le document (facture, contrat, bon de livraison, pièce d’identité…), extraire les données pertinentes avec leur signification (fournisseur, montant, date d’échéance, clauses), les valider contre des règles métier et les livrer au processus ou au système qui en a besoin. Le résultat n’est pas un texte, mais des données structurées prêtes à l’emploi.
En quoi l’IDP diffère-t-il de l’OCR traditionnel ? +
L’OCR traditionnel convertit une image en texte et a besoin de gabarits : il faut définir dans quelle zone de la page se trouve chaque champ, et chaque fournisseur ou format nouveau exige de configurer un autre gabarit. L’IDP comprend le contenu : il identifie le type de document et localise les champs par leur signification, pas par leur position, ce qui lui permet de tolérer des formats qu’il n’a jamais vus, des documents scannés de travers ou des factures de nouveaux fournisseurs sans travail préalable. Il renvoie en outre un score de confiance par champ, qui permet de n’envoyer en révision humaine que les cas douteux.
Quels documents peut-on traiter avec l’IDP ? +
Pratiquement tout document d’entreprise : factures fournisseurs et notes de frais, contrats et leurs clauses clés, bons de livraison et commandes, pièces d’identité pour les créations de dossiers et vérifications, bulletins de paie et documents RH, et le courrier entrant qu’il faut classer et router. Les meilleurs retours se trouvent généralement dans les flux les plus volumineux et les plus manuels : l’entrée des factures en comptabilité et la documentation client dans les processus d’onboarding.
Faut-il entraîner un modèle pour chaque type de document ? +
Avec la génération actuelle, non. Les modèles de langage avec vision permettent de classer et d’extraire en mode « zero-shot » : on leur indique quels champs on recherche et ils les localisent même s’ils n’ont jamais vu ce format précis. C’est le changement décisif par rapport à l’approche antérieure, où chaque type de document exigeait un projet d’entraînement avec des centaines d’exemples étiquetés. L’ajustement fin est réservé aux cas très spécifiques à fort volume.
Que se passe-t-il quand l’IA se trompe ou hésite ? +
Un IDP bien conçu ne vise pas 100 % d’automatisation, mais le bon circuit : les champs extraits portent un score de confiance et des règles de validation (concordance des montants, numéro fiscal valide, fournisseur existant), et seuls les documents qui ne franchissent pas ces seuils passent en révision humaine au sein du même flux. La personne corrige à l’écran, le processus continue et la correction reste auditée. C’est pourquoi l’IDP doit vivre dans un BPM : l’exception est une étape de plus du processus, pas un e-mail avec un fichier Excel.
La capture avec IDP a-t-elle une valeur fiscale en Espagne ? +
L’extraction de données en tant que telle n’exige pas d’homologation, mais si vous voulez détruire le papier après numérisation en Espagne, il vous faut un logiciel de numérisation certifiée homologué par l’AEAT (l’administration fiscale espagnole), qui garantit que l’image numérisée est une copie fidèle de l’original. Dokuflex dispose de cette homologation, de sorte que la capture intelligente et la numérisation à valeur fiscale se règlent dans le même flux.
Arrêtez de saisir des documents dès ce trimestre
Apportez vos factures, contrats ou bons de livraison réels à une session de 45 minutes : nous les traitons en direct avec l’IA documentaire de Dokuflex, montons le circuit de validation et repartons avec une estimation d’économie par document.